Que changent les "AI Overviews" de Google pour les internautes ?
Loris Guémart - - Numérique & datas - Génération ChatGPT - 22 commentairesPlus de paywalls, des sources aléatoires, et des informations erronées
Introduits cet été en France, plusieurs mois (ou années) après d'autres pays, les résumés IA du moteur de recherche de Google ont déjà changé la manière dont les internautes s'informent. Mais leur adoption imposée par Google change-t-elle quelque chose, selon les travaux de recherche menés dans d'autres pays dans lesquels les "aperçus IA" ont été mis en place depuis plus longtemps ?
Vous êtes journaliste chez Arrêt sur images. Pour écrire une chronique concernant l'usage du terme "oligarchie" par l'hebdomadaire britannique The Financial Times, vous avez trouvé un accès légal au site... sauf une petite partie, un contenu payant issu de Lex, une newsletter dédiée aux investissements financiers. Dans ce texte, le FT conteste le fonctionnement oligarchique créé au sein d'un actionnariat par les actions à vote multiple – qui donnent des pouvoirs plus importants à une catégorie d'actions et d'actionnaires. Et ce même si cette "oligarchie d'entreprise" a pu, dans de rares cas, se conclure positivement aussi pour les détenteurs d'actions de seconde classe. Comment le sais-je ? Parce que Google a eu la sympathie de me le résumer à plusieurs reprises avec des mots légèrement différents" dans une "AI Overview" (ou "Aperçu IA" en français) que je n'avais même pas demandée. Je cherchais seulement à retrouver le lien de l'article en question – modérément confiant envers Google, je ne l'inclus pas dans ma recension.
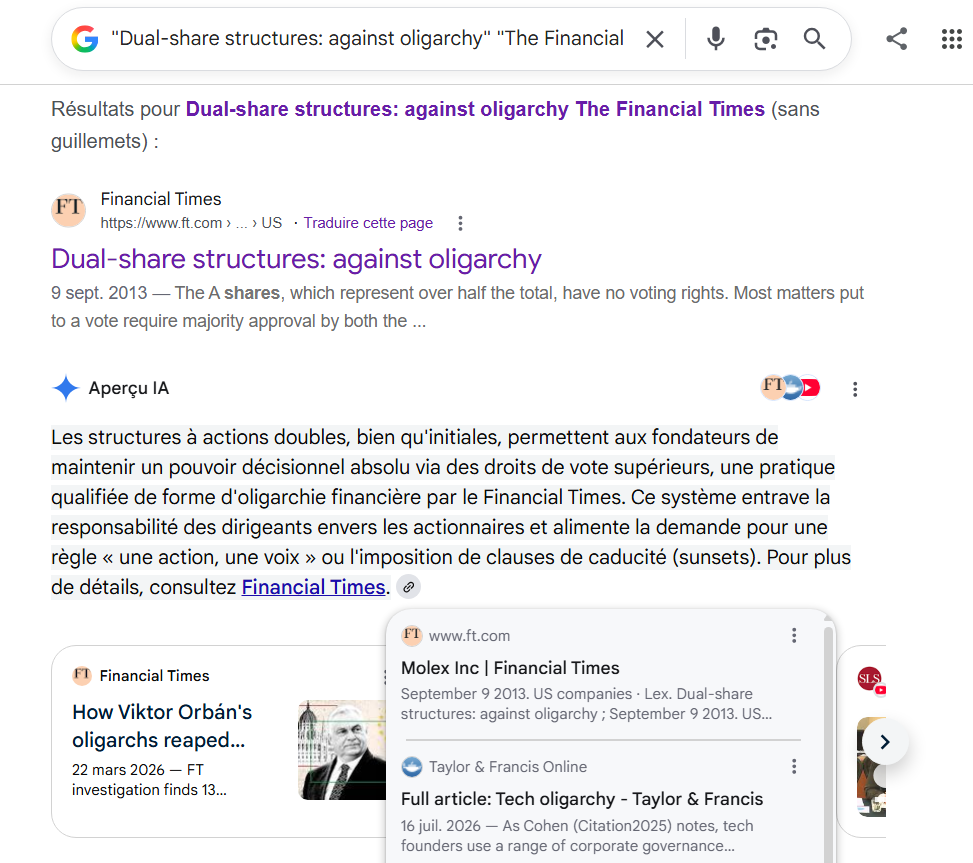
Mais ma curiosité est immédiatement attisée, comme par tout moyen permettant de faire disparaître un paywall médiatique. En effet, jusque-là, la plupart des IA étaient sévèrement limitées dans leurs recherches à cause de leur exclusion d'un grand nombre de médias... sauf le bot de Google, lui, autorisé par la force des choses : qui peut se passer d'être trouvable par le moteur de recherche hégémonique dans la plupart des pays du monde, ou dans ses résumés IA placés avant toute autre information ?
Je décide donc de prolonger l'expérimentation avec un site beaucoup moins accessible aux robots d'indexation de la firme de Mountain View : Arrêt sur images. En effet, notre paywall n'est pas, comme on dit dans le métier, "soft" (Google a accès à l'ensemble du contenu) à l'image de la grande majorité des médias payants, mais "hard" (Google est comme n'importe quel non-abonné·es et n'a donc pas accès à ce qui suit cette barrière numérique).
Google résume un de nos articles (auquel il n'a pas accès)
Que peut donc me dire l'aperçu IA d'un de nos récents articles, dont nos abonné·es n'ont pas voté la gratuité ? Je choisis l'exploration des avanies des journalistes "voyage" des grands journaux réalisée par Clara Barge. Cette fois-ci, je demande directement à Google "comment travaillent les journalistes «voyage» selon Arrêt sur images", la formulation sous forme de question étant la plus efficace pour susciter automatiquement l'encart IA. Le moteur de recherche me fournit obligeamment une réponse qui occupe l'intégralité de mon écran, tant sur mobile que sur l'écran d'ordinateur.
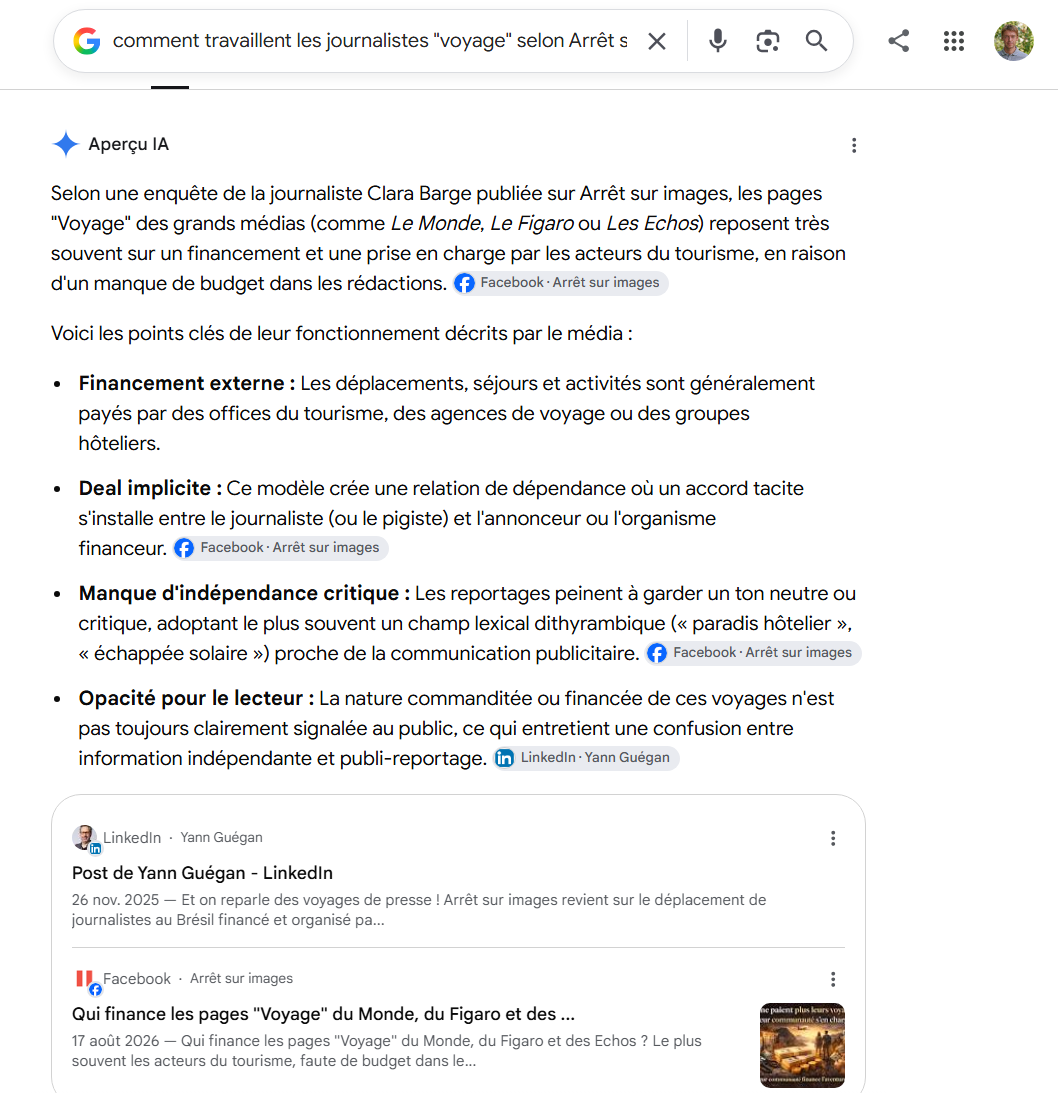
Au premier abord, c'est plutôt une réussite vu de l'internaute qui ne serait pas abonné·e à ASI mais souhaiterait connaître la substance de l'article. D'ailleurs, la plupart des informations affichées sont correctes... mais ne proviennent pas d'une lecture de l'article par le bot de Google. En réalité, l'aperçu IA rallonge autant que possible, qualité classique des grands modèles de langage, les maigres éléments à sa disposition : le post Facebook promouvant l'article auquel il renvoie systématiquement l'internaute, le titre, le sous-titre, le chapô et un morceau du premier paragraphe. Google met sous sa propre plume des éléments qui figuraient entre guillemets, donc auxquels ASI ne souscrivait pas forcément. Et surtout, la société se contente du générique "les réponses de l'IA peuvent contenir des erreurs" en tout petits caractères au pied du résumé, plutôt que de signaler qu'il n'a pas eu accès à 95 % de l'article qu'il résume avec assurance.
Cette AI Overview ajoute aux sources un post Linkedin du journaliste Yann Guégan. Certes, il y partageait un article d'ASI... mais un article écrit plusieurs mois plus tôt, et sans rapport avec les journalistes "voyage" puisqu'il concernait des voyages de presse organisés par deux multinationales – Total et Engie. Ce qu'en tire Google ? "La nature commanditée ou financée de ces voyages n'est pas toujours clairement signalée au public, ce qui entretient une confusion entre information indépendante et publi-reportage." Certes, c'est aussi vaguement applicable aux reportages "voyage", mais le caractère pas totalement faux de l'utilisation de ces éléments relève plus du coup de chance algorithmique que d'une judicieuse déduction.
Pour avoir un résumé, posez une question (mais pas sur des sujets sensibles)
Les sciences sociales françaises n'ont pas encore exploré les "AI Overviews", déployées seulement depuis le 22 juillet en France. Mais dans d'autres pays dans lesquels Google a lancé cette nouvelle fonction dès 2024, les scientifiques épluchent déjà ses réponses depuis de nombreux mois. Si la plupart des recherches concernent surtout les médias, ou plutôt annoncent leur mort prochaine – on y reviendra dans un second volet –, quelques-unes lèvent le voile sur ce qui attend les internautes.
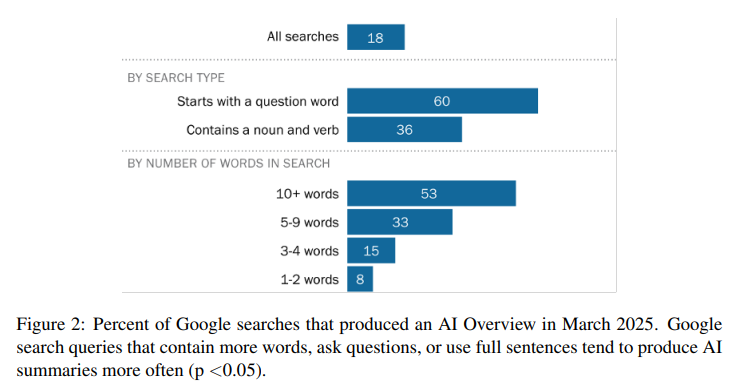
Lors d'une conférence consacrée aux sciences sociales appliquées au numérique quatre chercheuses du Pew research center ont présenté une étude observationnelle des recherches réalisées par 900 adultes aux États-Unis, pendant un mois. L'analyse de près de 69 000 recherches réalisées en mars 2025 a renvoyé des résumés IA dans 18 % des cas. Elles ont observé que "les requêtes plus longues, les requêtes commençant par un terme interrogatif, et les requêtes comportant à la fois un nom et un verbe" accentuaient massivement la probabilité que Google injecte une "IA Overview".
Dans une autre étude non encore publiée, récemment diffusée sur la plateforme de prépublication ArXiv, trois chercheurs exerçant aux États-Unis, à l'Université George Washington de Saint Louis, ont étudié plus de 55 000 recherches réalisées pendant 40 jours en 2026. Ils ont établi que 13,7 % des recherches suscitaient un résumé IA... et confirmé que ce taux montait à 64,7 % pour "les requêtes sous forme de questions". Les recherches portant sur "des thèmes politiquement sensibles" récoltaient néanmoins un taux de résumés IA significativement inférieur, "suggérant une vigilance éditoriale non signalée dans la mécanique de déclenchement" des résumés IA par Google, écrivent les scientifiques. Autrement dit, Google restreint volontairement son IA sur certains sujets sans indiquer quand c'est le cas.
Les résumés IA ne sont pas une synthèse de la première page des résultats
Ce n'est pas tout : la même étude relève que presque 30 % des sites cités par les "AI Overviews" ne figurent pas sur la première page des résultats de recherche traditionnels. Ils soupçonnent donc "un mécanisme de sélection des sources distinct de l'algorithme de classement des recherches". Les chercheurs observent aussi que la distribution des sources est "nettement plus large" au sein des résumés IA que dans la première page de résultats (qui propose dix pages web, ndlr) d'une recherche Google. Les domaines les plus cités par les résumés ? YouTube, Wikipedia, Facebook, Instagram et le quotidien USA Today. Mais contrairement aux études menées précédemment, ils constatent que la "crédibilité moyenne" des sites web cités par les résumés IA est légèrement plus élevée que ceux présentés pour les mêmes recherches en première page de Google.
La sélection distincte des sources entre le moteur de recherche et l'indexation IA de Google semble faire consensus. On la retrouve par exemple aussi dans une étude d'avril 2026 en phase de prépublication, réalisée par six chercheurs universitaires aux États-Unis à partir de 11 500 requêtes de recherche. Concernant l'origine des sources, eux constatent que "la recherche Google traditionnelle a significativement plus de chances de renvoyer des informations issues de sites web populaires ou institutionnels, tandis que les recherches à travers l'IA générative ont significativement plus de chances de renvoyer des informations issues de Google", notamment YouTube.
La plateforme vidéo de Google semble en effet massivement favorisée au sein des résumés IA, confirme une autre étude expérimentale menée aux États-Unis sur 900 recherches liées à la santé : alors que la part moyenne de la plateforme dans les 10 premier résultats s'établit à un maigre 0,6 %, elle se retrouve décuplée à 6,8 % des citations au sein des "AI Overviews". Pourquoi ? "L'IA utilise [un site de santé institutionnel fiable] pour apprendre ce qu'est une attaque cardiaque, mais pourrait citer une vidéo YouTube afin de conserver l'attention de l'utilisateur", suggèrent les quatre chercheurs allemands ayant réalisé cet examen. "Ce comportement sape la structure même des citations du web ouvert, car le trafic et la visibilité sont détournés des créateurs du contenu sanitaire de qualité."
Des chercheurs canadiens ont découvert un autre aspect troublant, à travers l'étude de 29 000 requêtes de recherche portant sur des thèmes pouvant affecter les finances personnelles, la sécurité, les conseils juridiques et la santé des internautes les formulant. "Ces sujets sont sensibles de manière inhérente : des informations imprécises ou trompeuses peuvent engendrer des conséquences néfastes dans la vraie vie." Des types de requêtes "particulièrement sensibles à la sélection des sources et des citations", justifient-ils. Concernant ces thèmes, ils ont observé que "les documents générés par IA étaient plus fréquemment cités par les résumés IA que les documents d'origine humaine", et que cette différence s'expliquait principalement par la présence d'autres sources que celles issues des meilleurs résultats du moteur de recherche.
Des erreurs, des erreurs, des erreurs (notamment en santé)
Dès 2024, au lancement des résumés IA aux États-Unis, de flagrantes erreurs terminent dans les médias, à l'instar de cet article du MIT Technology Reviewse demandant si l'on peut se fier à des réponses conseillant de manger des pierres ou de faire des pizzas avec de la glue : "Un grand modèle de langage génère avec facilité des textes à partir de sources fournies, mais ce n'est pas la même chose qu'une information correcte", y expliquait une spécialiste universitaire allemande. En janvier 2026, le Guardian britannique pose à Google des questions précises liées à la santé, entre autres concernant la nourriture adaptée pour les personnes atteintes de cancer du pancréas, ou les résultats normaux observés après des tests sanguins examinant le fonctionnement du foie. Les réponses sont fausses... et donc dangereuses pour les internautes qui auraient posé la question, y compris lorsque les sources citées, elles, font part d'informations médicales correctes. Google retire alors certains des résumés IA générés par ces questions.
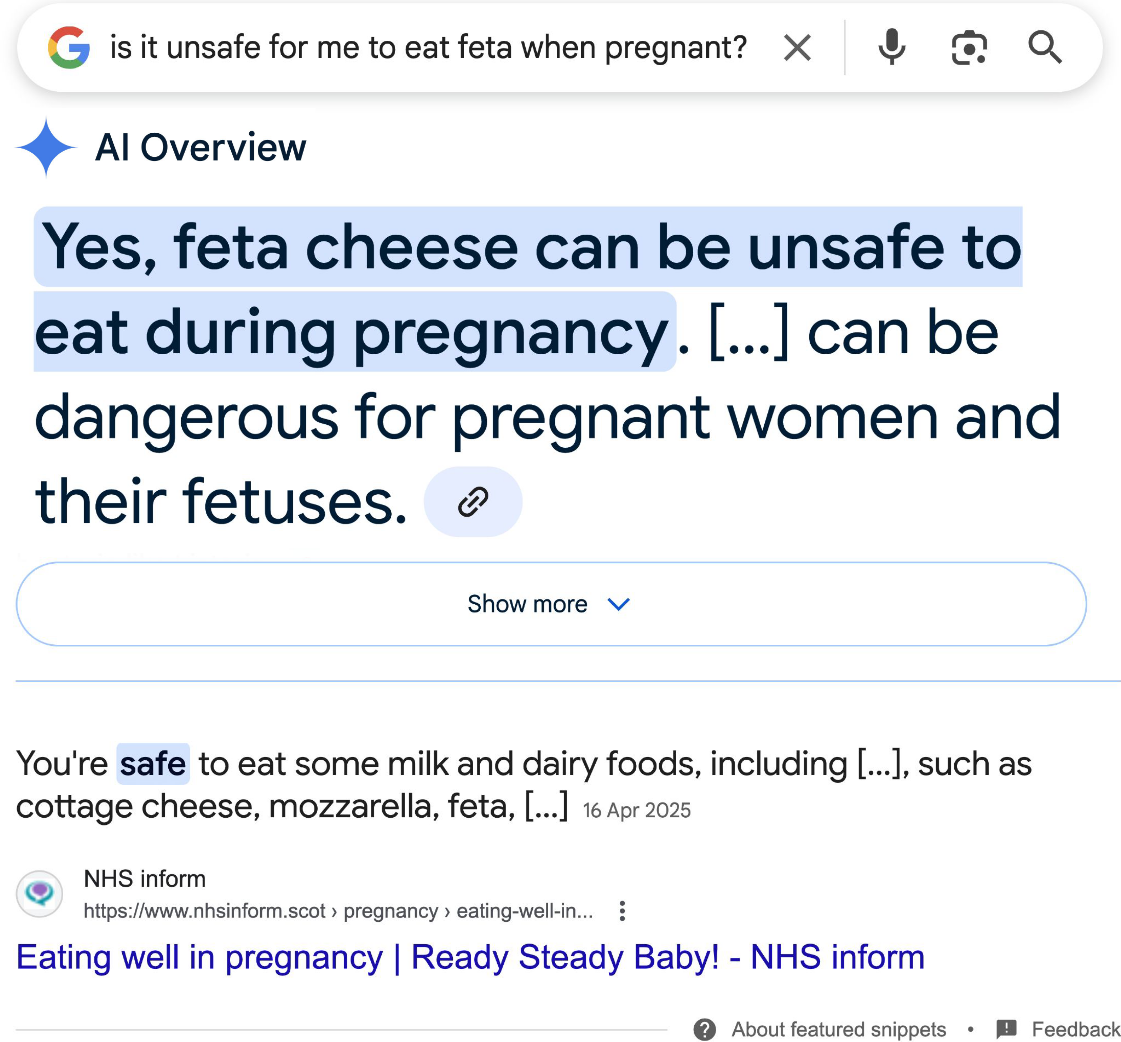
Une étude diffusée au printemps 2026 a cherché à établir la fiabilité des résumés IA et des encadrés-réponses situés en haut de la page de résultats de Google, concernant les conseils liés à la grossesse et aux soins des bébés. À partir d'une analyse de plus de 1 500 questions autour de ces deux thèmes, ces chercheurs européens observent, d'une part, que lorsqu'une page de résultats propose et un résumé IA, et des encadrés-réponses, ceux-ci se contredisent dans un tiers des cas. Et ce y compris avec des requêtes pouvant risquer la santé d'une mère et de son enfant à naître : c'est le cas d'une recherche concernant la possibilité pour une femme enceinte de manger de la feta, Google répondant "oui" et "non" tout en omettant le seul facteur important, en l'occurrence la pasteurisation – la réponse a depuis été corrigée. Les chercheurs constatent également que dans l'immense majorité des cas, ces textes présentés directement par Google ne comportent "pas de garde-fous médicaux" tels qu'une invitation à consulter un médecin.
Enfin, même quand les résumés IA ne comportent aucune erreur médicale, ils peuvent comporter d'autres déficiences problématiques. Comment ? Dans une étude de juin 2026, deux chirurgiens ORL ont évalué les réponses fournies concernant six questions fréquemment posées à propos de la reconstruction de la machoire par greffe d'os de la jambe. La première conclusion est plutôt positive : les résumés IA de Google fournissent "des informations fiables" concernant cette procédure. La seconde conclusion l'est moins : l'internaute "doit posséder les compétences linguistiques d'une personne de 16 ans et demi pour comprendre les réponses", ce qui est, poursuivent les chercheurs irlandais ayant réalisé l'étude, "significativement plus élevé que l'âge recommandé de 11 à 13 ans pour les informations à caractère médical".
Les aperçus IA reproduisent les biais de leurs sources
Au-delà des erreurs, comment l'IA de Google traite des sujets sensibles lorsqu'elle choisit d'y répondre ? Une équipe de recherche espagnole a tenté de le savoir à propos de la perception des réfugié·es, en posant les dix questions les plus formulées sur ce thème par les internautes – telles que "qui sont les réfugiés ?" ou "qui est considéré comme un réfugié ?". Ils se demandaient en particulier si "les systèmes d'IA générative de Google privilégiaient plutôt les sources institutionnelles et hautement structurées", ce qui "mène à une représentation étroite des réfugiés". Et la réponse est... oui, du moins à partir des résumés IA fournis par Google en Espagne en septembre 2025.
Dans ce cas d'étude, Google choisit en effet de signaler comme source principale de sa notice générée par IA soit des pages institutionnelles telles que celles du Haut commissariat aux réfugiés des Nations-Unies, soit Wikipedia. Quant aux réponses elles-mêmes, les scientifiques établissent trois "récits dominants". D'une part, les résumés IA "priorisent le point de vue de la protection humanitaire", ce qui "place les réfugiés en sujets passifs du droit international". Une perspective qu'on retrouve concernant les raisons qu'ils ou elles peuvent avoir de quitter leurs pays d'origine, "dramatiques et avec une attention particulière portée à la vulnérabilité". Enfin, Google met en avant les statistiques quantitatives et spatiales, "réduisant les réfugiés à des nombres et à des frontières nationales".
Selon les chercheurs, ces choix éditoriaux "présentent les réfugiés comme des sujets passifs qui ne reçoivent que de l'aide ou une protection, invisibilisant leur capacité à prendre des décisions et à contrôler leurs propres vies". Les informations présentées, elles, "tendent à homogénéiser la réalité des réfugiés en omettant la diversité des trajectoires, des contextes et des situations individuelles qui caractérisent ce groupe de personnes" et "construisent" aussi "des frontières entre «eux» et «nous»". Ces textes générés par le grand modèle de langage de Google "excluent de manière générale les voix critiques ou alternatives", ce qui "empêche le questionnement des discours dominants et complique l'accès aux analyses qui problématisent ou nuancent la situation des réfugiés". Ce n'est pas tout : ces résumés associent aussi les réfugiés à "des crises et des événements extraordinaires", par exemple l'invasion de l'Ukraine, et non à "des flux migratoires réguliers".